先週、社内のファイルサーバーが突然電源が入らなくなった。原因を調べている間、営業部は見積書のテンプレートにアクセスできず、経理は前月の請求データを開けず、製造部は共有していた作業手順書を確認できなかった。たった1台のサーバーが止まっただけなのに、なぜこれほど多くの業務が同時に止まるのか。復旧してから、ふとそんな疑問が頭をよぎった方もいるのではないでしょうか。
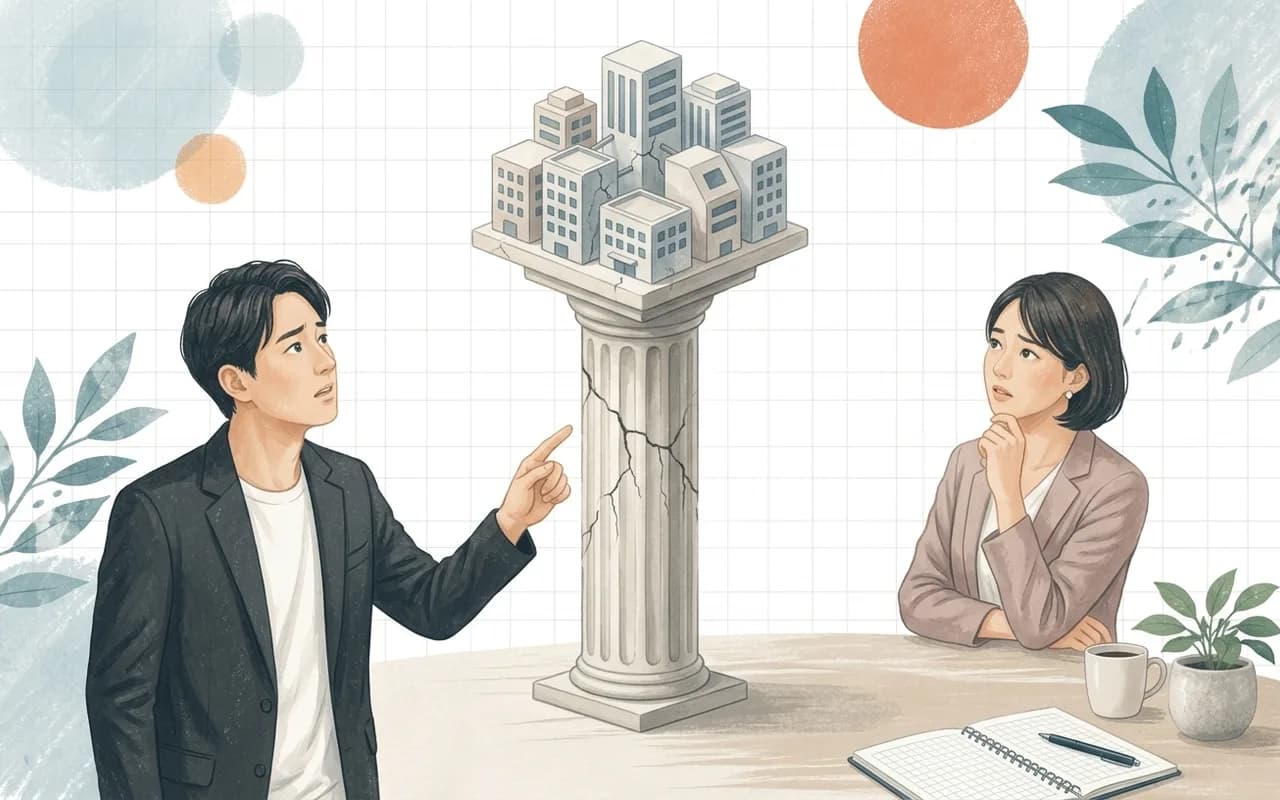
これは特殊な事故ではありません。多くの中小企業では、1台のサーバーや1人の担当者に、想像以上に多くの業務が依存しています。普段はその依存関係が見えないため気づきにくいだけで、実際には「そこが止まると会社全体が止まる」ポイントが、社内のあちこちに潜んでいます。
この記事では、そうした「そこが止まると業務全体が止まってしまう箇所」、すなわち単一障害点(SPOF)を、どうやって洗い出し、どう備えればよいかを具体的に解説します。特別な技術知識やIT予算がなくても、今日から着手できる手順に絞って整理しました。
この記事で分かること
社内サーバー・機器・人といった「止まると困るもの」を体系的に洗い出し、影響範囲を把握したうえで、現実的な備え方を決めるまでの手順を解説します。扱う内容は次の4つです。
- 単一障害点とは何か: なぜ「たった1つ」が全体を止めてしまうのか、具体例で理解する
- 洗い出しの手順: サーバー・ネットワーク機器・ソフトウェア・人、それぞれの依存関係をどう調べるか
- 影響範囲の可視化: 見つかった依存点を、業務への影響度で並べ替える方法
- 現実的な備え方: 予算をかけずにできる対策と、投資が必要な対策の線引き
なお、この記事は「単一障害点を見つけて備える」ことに焦点を当てています。社内システム全体の棚卸しをまだ行っていない方は、先に『社内システムの現状調査(棚卸し)のやり方』で全体像を把握してから、この記事で「特に危険な箇所」を絞り込む順序をおすすめします。すでに管理台帳を運用している方は、その台帳に単一障害点の情報を追記していく形でこの記事を活用してください。
単一障害点とは何か。なぜ「1つ」が全体を止めるのか
単一障害点とは、冗長化(同じ機能を持つ予備がもう1つ用意されている状態)がされておらず、そこが故障・停止すると業務全体に影響が及んでしまう箇所のことです。IT業界では英語の頭文字を取って「SPOF」と呼ばれることもあります。
分かりやすい例で考えてみましょう。
会社に電話回線が1本しかない場合、その回線が故障すると、顧客からの電話も取引先への発注確認も、すべてできなくなります。これが単一障害点です。もし固定電話と携帯電話の両方で連絡が取れる体制になっていれば、片方が故障してももう片方で業務を継続できます。これが「冗長化されている」状態です。
社内システムにおける単一障害点は、この電話回線の例よりもずっと見えにくい形で存在しています。理由は3つあります。
- 普段は問題なく動いている: 壊れるまでは正常に機能しているため、そこが単一障害点だと気づく機会がない
- 依存関係が複雑: 1台のサーバーに複数の業務システムが同居していることが多く、影響範囲を正確に把握しづらい
- 人も単一障害点になりうる: 機器だけでなく、「その人しか設定方法を知らない」という状態も、人という単一障害点である
特に3番目は見落とされがちです。サーバーが二重化されていても、そのサーバーの障害対応ができるのが社内で1人だけという状態であれば、その人が休暇中や退職した場合に、結局は同じ問題が起こります。単一障害点は、機器・ソフトウェア・ネットワーク・人のすべてのレイヤーで考える必要があります。
単一障害点が引き起こす被害の広がり方
単一障害点が実際に故障したとき、被害がどう広がるかを整理すると、次のような段階を踏むことが多いです。
| 段階 | 起きること |
|---|---|
| 直接的な機能停止 | その機器・システム自体が使えなくなる |
| 依存業務の停止 | そのシステムを直接使っていた業務が止まる |
| 連鎖的な停止 | そのシステムからデータを受け取っていた別のシステム・業務も止まる |
| 対外的な影響 | 顧客対応の遅延、納期遅延、取引先への連絡不能など社外に波及する |
1台のサーバーが止まっただけで、社外の取引先にまで影響が及ぶケースは珍しくありません。だからこそ、単一障害点は「壊れてから対応する」のではなく、平時のうちに「壊れたら何が止まるか」を把握しておくことが重要になります。
洗い出しの全体方針。3つのレイヤーで考える
単一障害点の洗い出しは、次の3つのレイヤーに分けて進めると、抜け漏れが少なくなります。
- 物理レイヤー: サーバー・ネットワーク機器・端末など、物理的に壊れうるもの
- ソフトウェア・データレイヤー: 業務システム・ソフトウェアライセンス・データの保存先
- 人レイヤー: 特定の担当者しか対応できない業務・設定・知識
多くの担当者は最初に物理レイヤーだけを調べて満足してしまいがちですが、実際に業務が止まる原因は人レイヤーに起因することも多くあります。3つのレイヤーをすべて調べることを最初に意識しておいてください。
すでに社内システムの棚卸し(何のシステムがあるかの一覧化)を終えている場合は、その情報を土台に「止まると特に困るもの」を絞り込む作業として進められます。まだ棚卸しをしていない場合は、この記事の手順を進める中で、結果的に簡易的な棚卸しにもなります。
物理レイヤーの洗い出し。壊れうる機器を数え上げる
まず、社内で稼働している物理的な機器のうち、それが止まると業務に影響するものを洗い出します。
サーバー・ネットワーク機器の依存先を確認する
サーバー室や配線盤にある機器を1台ずつ確認し、それぞれが「何の業務を支えているか」を紐づけていきます。
- ファイルサーバー: どの部署のどんなファイルを保存しているか
- ルーター・スイッチ・無線LANアクセスポイント: どこまでの範囲の通信を中継しているか(1台のルーターが全社のインターネット接続を担っていないか)
- プリンターサーバー・複合機: 帳票印刷など、止まると即座に業務が滞る用途に使われていないか
- 社内で稼働させている業務アプリケーション用サーバー: 販売管理・生産管理・会計など、何のシステムが載っているか
特に注意したいのが、1台のサーバーに複数の役割が同居しているケースです。ファイル共有と業務アプリケーションの両方が同じ1台のサーバー上で動いている場合、そのサーバーが故障すると、本来なら別々の障害として扱われるべき2つの機能が同時に止まります。1台に載っている役割の数が多いほど、そのサーバーは単一障害点としての危険度が高いと考えてください。
ネットワーク経路の単一障害点を確認する
意外と見落とされやすいのが、インターネット回線そのものです。
- 契約している回線事業者は1社だけか
- 社内の主要な通信がすべて1本の回線に集約されていないか
- クラウドサービスを多用している会社ほど、回線が止まったときの影響が大きくなる
回線事業者が1社のみの場合、その回線に障害が起きると、クラウド上の業務システムを含めてほぼすべての業務が停止します。これは典型的な単一障害点です。
電源まわりの単一障害点
サーバーやネットワーク機器そのものが正常でも、電源が落ちれば同じ結果になります。
- サーバー室の電源は、複数の系統(ブレーカー)に分散されているか、それとも1系統に集中しているか
- 停電時にサーバーを安全にシャットダウンするための無停電電源装置(オンプレミス環境で稼働しているサーバーであれば特に重要)が設置されているか
- 空調(サーバー室の温度管理)が止まった場合、機器が熱暴走して停止する可能性はないか
電源や空調は、ITの担当者だけでなく総務・施設管理の担当者と情報を共有しながら確認する必要がある領域です。
ソフトウェア・データレイヤーの洗い出し
物理的な機器だけでなく、ソフトウェアやデータの保存構造にも単一障害点は存在します。
「そのファイルしかない」状態を探す
最も基本的で見つけやすい単一障害点は、重要なデータのコピーが1箇所にしか存在しない状態です。
- 経理データ、顧客リスト、契約書のスキャンデータなどが、1台のパソコンのローカルドライブにしか保存されていないか
- クラウドストレージを使っている場合でも、そのクラウドサービスのアカウントが1人にしか紐づいていないか(その人が退職・異動すると誰もアクセスできなくなる)
- 重要なExcelマスターファイルが、特定の担当者のパソコンだけで管理されていないか
この確認には、バックアップの考え方が直接関わってきます。データの単一障害点をなくす基本は、複数の場所にコピーを持つことです。
バックアップの3-2-1ルールで自社の状態を点検する
データのバックアップに関する代表的な考え方として、3-2-1ルール(バックアップ)があります。これは「重要なデータは3つのコピーを、2種類の異なる媒体に、うち1つは遠隔地(オフサイト)に保管する」という原則です。
自社のバックアップ体制をこの観点で点検すると、単一障害点が見つかりやすくなります。
- コピーの数は3つあるか(元データ+バックアップ2つ、が目安)
- 同じ外付けHDD、同じサーバー内だけに複数保存していないか(媒体が同じだと、その媒体自体の故障で全滅する)
- すべてのバックアップが社内の同じ建物内に保管されていないか(火災・水害・盗難などが起きると元データもバックアップも同時に失われる)
独立行政法人情報処理推進機構(IPA)が公開している「中小企業の情報セキュリティ対策ガイドライン」第4.0版では、情報セキュリティ対策の基本項目の1つとして「バックアップを取ろう」を挙げ、重要情報の消失に備えて定期的にバックアップを取得すること、バックアップに使用する装置・媒体はバックアップ時のみパソコンと接続すること、バックアップしたデータを安全な場所に保管すること、バックアップしたデータを戻せるか定期的に確認することを推奨しています。
万が一の故障や災害時にも、どのIT資産が事業に不可欠か、どこにバックアップがあるかを把握していれば、迅速な対応が可能です。
——IPA「中小企業の情報セキュリティ対策ガイドライン」第4.0版より
「バックアップを取っている」だけでは不十分で、「戻せることを確認している」「離れた場所にも保管している」まで満たして初めて、単一障害点が解消された状態と言えます。バックアップを取っていても、復元テストを一度も行っていないために、いざという時に破損していて使えなかった、という事態も起こりえます。バックアップ設計の基本的な考え方は、ランサムウェア対策、中小企業は何から始めるかでも扱っています。
目標復旧時間(RTO)と目標復旧時点(RPO)を意識する
前述のIPAガイドラインでは、事業上重要なシステムについて、目標復旧時間(RTO)と目標復旧時点(RPO)に合わせてバックアップ取得や手順整備を行うことを推奨しています。
- 目標復旧時間(RTO): 障害発生から、業務を再開できる状態まで復旧するのに、どれだけの時間をかけてよいかの目標値
- 目標復旧時点(RPO): 障害が発生した際に、どの時点までのデータの損失であれば許容できるかの目標値(直近のバックアップ取得時点を指す)
たとえば「RTOは24時間以内、RPOは前日夜間のバックアップまで」と決めておけば、「1日分のバックアップの遅れは許容するが、復旧作業は1日以内に終わらせる」という具体的な目標を持って備えることができます。逆にこの目標が決まっていないと、実際に障害が起きたときに「どこまで急ぐべきか」「どこまでのデータ損失なら仕方ないか」の判断基準がなく、現場が混乱します。
すべてのシステムに同じ厳しさのRTO・RPOを設定する必要はありません。止まると即座に業務が止まる基幹システムは短いRTOを、多少の遅れが許容できる社内資料の共有フォルダなどは長めのRTOを、というように、システムの重要度に応じて目標値にメリハリをつけることが現実的です。
ライセンス・契約の単一障害点
見落とされやすいのが、ソフトウェアライセンスや契約そのものが1箇所に集中しているケースです。
- 業務で使う重要なソフトウェアの契約者・支払い担当者が1人に集中しており、その人しか契約内容を把握していない
- ライセンスの更新期限が近づいていることに、誰も気づかないまま失効し、突然使えなくなる
- 保守契約の窓口が1つの担当者個人の連絡先になっており、会社の代表窓口を通していない
これらは機器の故障とは異なるタイプの単一障害点ですが、「業務が突然止まる」という結果は同じです。契約・ライセンス関連の情報は、個人の記憶やメールボックスだけでなく、会社として共有できる場所に記録しておく必要があります。
人レイヤーの洗い出し。属人化した知識・権限を探す
最後に、最も見つけにくく、しかし影響が大きい「人」の単一障害点を洗い出します。
「その人しかできない」作業をリストアップする
社内の業務を思い返しながら、次のような状態になっている作業がないかを確認してください。
- 特定のシステムの管理者パスワードを、1人しか知らない
- 月次処理・年次処理の手順が、マニュアル化されておらず、担当者の頭の中にしかない
- サーバーやネットワーク機器の設定変更ができるのが、社内で1人だけ
- 特定の取引先とのやり取りが、1人の担当者を通してしか行われていない
これらは、その担当者が急病や事故で長期間出社できなくなった場合、あるいは退職した場合に、そのまま業務停止に直結します。属人化と呼ばれるこの状態は、単一障害点の中でも特に対策が後回しにされやすい領域です。
権限・アカウントの集中を確認する
システムの管理者権限が、特定の1人のアカウントだけに集中していないかも確認しましょう。
- クラウドサービスの管理者アカウントが、退職予定の従業員名義のまま放置されていないか
- 複数のシステムで同一の管理者アカウントを使い回しており、そのアカウントが使えなくなると全システムに影響が及ばないか
- 多要素認証(MFA)(多要素認証)を設定している場合、認証に使うスマートフォンなどのデバイスが特定の1人にしか渡っていないか
管理者権限は、最低でも2人が持てる体制を整えることが望ましいとされています。1人だけが管理者権限を持つ状態は、その人自身が「人としての単一障害点」になっている状態です。
洗い出した単一障害点を、影響度で並べ替える
物理・ソフトウェア・人の3レイヤーで洗い出しを終えると、思った以上に多くの候補がリストアップされるはずです。すべてに同じ熱量で対策することは現実的ではないため、影響度に応じて優先順位をつける必要があります。
影響範囲を書き出す
見つかった単一障害点それぞれについて、次の3点を書き出してみてください。
- 止まったら、どの業務・部署が影響を受けるか
- 止まってから、どれくらいの時間で業務に支障が出始めるか(即座に困るのか、数日は猶予があるのか)
- 代替手段はあるか(手作業で一時的に代替できるか、まったく代替できないか)
この3点を整理すると、「影響範囲が広く」「猶予時間が短く」「代替手段がない」ものほど、優先的に対策すべき単一障害点だと判断できます。
簡易的な優先順位表を作る
すべてを表計算ソフトで一覧化すると、対策の順序が見えやすくなります。
| 単一障害点 | 影響を受ける業務 | 猶予時間 | 代替手段 | 優先度 |
|---|---|---|---|---|
| ファイルサーバー | 全部署の共有ファイル | 数時間 | なし | 高 |
| 経理担当者Aさんの月次処理知識 | 経理の月次締め | 数日〜1週間 | 一部あり(前任者に相談可) | 中 |
| プリンター1台 | 営業部の帳票出力 | 数時間 | 他部署のプリンターで代替可 | 低 |
代替手段がまったくなく、猶予時間も短いものが、最優先で手を打つべき単一障害点です。逆に、代替手段があるものは、緊急度は下がります。限られた時間と予算の中で、どこから着手するかを判断する材料として活用してください。
現実的な備え方。予算をかけずにできることから
単一障害点が見つかったからといって、すべてに高額な冗長化投資をする必要はありません。予算規模に応じて、段階的に対策を進める考え方を持つことが重要です。
コストをかけずにできる対策
- バックアップ体制の見直し: 前述の3-2-1ルールに沿って、コピーの数・媒体の種類・保管場所を見直す。既存のクラウドストレージの無料枠を活用できる場合もある
- 手順書の作成: 「その人しかできない」作業を、簡単なメモ程度でもよいので文書化する。完璧なマニュアルでなくても、いざというときの手がかりがあるだけで復旧速度は大きく変わる
- 管理者権限の複数化: 追加コストなしで、既存の管理者アカウントの権限を信頼できる2人目に付与する
- 契約情報の共有: 個人のメールボックスに眠っている契約書・ライセンス情報を、共有ドライブに集約する
これらは今日から着手できる対策です。特に手順書の作成と権限の複数化は、コストゼロで単一障害点のリスクを大きく下げられるため、最優先で取り組むことをおすすめします。
投資が必要な対策
- サーバーの二重化(予備機の用意、あるいはクラウドサービスへの移行)
- インターネット回線の複数契約(モバイル回線を予備にするなど、比較的低コストな選択肢もある)
- 無停電電源装置(UPS)の設置
- バックアップの自動化・遠隔地保管サービスの契約
これらは一定の予算が必要になるため、前述の優先順位表で「優先度:高」と判定されたものから、稟議を通す形で計画的に投資を検討してください。すべてを一度に対策しようとすると、予算的にも作業量的にも現実的ではありません。
対策を決める際の判断軸
対策の要否を判断する際は、次の視点を持つと整理しやすくなります。
- その単一障害点が実際に故障する確率はどれくらいか(古い機器ほど確率は上がる)
- 故障したときの被害額(業務停止による損失、復旧にかかる費用)はどれくらいか
- 対策にかかる費用と、被害額を比較して見合うか
すべての単一障害点をゼロにすることは、現実的にはほぼ不可能です。「どこまでのリスクなら許容し、どこからは対策すべきか」という線引きを、経営層と共有しながら決めていく姿勢が求められます。
老朽化した機器は単一障害点になりやすい
単一障害点の中でも、特に故障確率が上がっているのが、老朽化した機器やEOL(サポート終了)を迎えたソフトウェアです。使用年数が長い機器ほど部品の劣化が進み、突発的な故障リスクが高まります。加えて、サポートが終了したレガシーシステムは、脆弱性が見つかっても修正パッチが提供されないため、故障だけでなくセキュリティ面のリスクも重なります。
洗い出しの過程で、次のような機器が見つかった場合は、優先順位表の中でも特に注意して扱ってください。
- 導入から5年以上経過しているサーバー・ネットワーク機器
- メーカーのサポートが既に終了している、または終了時期が近いOS・ソフトウェア
- 「壊れたら代わりがない」機種で、既に製造終了・部品調達が困難になっているもの
老朽化した機器が単一障害点として特定できたら、単に「壊れる前に交換する」という判断だけでなく、EOL対応の進め方そのものを検討する必要が出てくることもあります。個別の判断基準は『Windows Server のサポート終了(EOL)対応の進め方』で詳しく扱っていますので、老朽化した機器が単一障害点リストの上位に来た場合は、あわせて参照してください。
洗い出しと対策を、一度きりで終わらせない
単一障害点の洗い出しは、一度やって終わりではありません。会社の状況は常に変化しており、新しいシステムを導入すれば新しい単一障害点が生まれますし、担当者が異動・退職すれば人に関する単一障害点も変わります。
- 新しいシステム・機器を導入するたびに、単一障害点の観点でチェックする: 導入時に「これが1つだけの構成になっていないか」を確認する習慣をつける
- 半年に1回程度、洗い出しリストを見直す: 完璧でなくてもよいので、定期的に更新する仕組みを作る
- 実際に障害が起きたときは、原因を記録し、次の対策に活かす: 小さな障害であっても、「なぜ止まったか」「代替手段は機能したか」を振り返ることで、リストの精度が上がっていく
一度に完璧なリストを作ろうとすると、時間がかかりすぎて挫折しやすくなります。まずは目についた範囲から粗くリストアップし、少しずつ精度を上げていく進め方をおすすめします。
まとめ
単一障害点とは、そこが壊れると業務全体が止まってしまう箇所のことです。サーバーやネットワーク機器といった物理的なものだけでなく、データの保存構造、ソフトウェアライセンス、そして「その人しか知らない」という属人化した知識や権限も、すべて単一障害点になりえます。
洗い出しは、物理・ソフトウェア/データ・人という3つのレイヤーに分けて進め、見つかった候補は影響範囲・猶予時間・代替手段の有無で優先順位をつけることで、限られた時間と予算の中でも実効性のある対策につなげられます。バックアップの3-2-1ルールや、IPAガイドラインが示す目標復旧時間(RTO)・目標復旧時点(RPO)の考え方も、優先順位づけと対策の目標設定に活用できます。
すべてをゼロにすることはできませんが、「どこが単一障害点で、壊れたら何が止まるか」を把握しているだけで、実際に障害が起きたときの対応速度は大きく変わります。まずは目につく範囲からリストアップを始めてください。
単一障害点の洗い出しを含む、社内システム全体の現状把握をまだ行っていない方は、『社内システムの現状調査(棚卸し)のやり方』を先に参照することをおすすめします。また、洗い出した情報を継続的に記録・更新していく仕組みについては、『属人化を防ぐ社内システム管理台帳の作り方』で詳しく解説しています。